Slutt å overdrive karrieren din ved å jage etter alle maskinlæringstrender som dukker opp på Hacker News. Maskinlæringsfeltet er enormt, og å prøve å være ekspert på alt fører til at du blir middelmådig i det meste. Bedrifter ansetter ikke lenger generalister. De ansetter spesialister som kan løse spesifikke, verdifulle problemer som direkte påvirker bunnlinjen deres.
Arbeidsmarkedet innen maskinlæring har modnet betraktelig. For fem år siden ansatte bedrifter alle som hadde «maskinlæring» på CV-en. I dag ser de etter ingeniører med dyp ekspertise innen bestemte domener. De ønsker noen som har bygget anbefalingssystemer i stor skala, ikke noen som har jobbet med ti forskjellige områder. De ønsker spesialister på datasyn som har sendt modeller til produksjon, ikke ingeniører som har fullført alle tilgjengelige nettkurs.
Dette skiftet skaper enorme muligheter for ingeniører som spesialiserer seg strategisk. Å velge riktig spesialisering kan tredoble jobbmulighetene dine og øke lønnen din betydelig. Velg feil, og du vil konkurrere med tusenvis av andre om de samme generiske rollene. Forskjellen mellom disse resultatene kommer ned til å forstå hvor etterspørselen faktisk finnes kontra hvor hypen finnes.
Nøkkelfunksjoner
NLP og LLM-ingeniørfag dominerer ansettelsesetterspørselen akkurat nå. Alle selskaper ønsker å integrere språkmodeller i produktene sine.
Spesialister på datasyn fortsatt høy etterspørsel på tvers av autonome kjøretøy, helsevesen, detaljhandel og produksjonssektoren.
Anbefalingssystemingeniører ha premiumlønninger i e-handel, strømming og sosiale medier-selskaper.
MLO-er og produksjons-ML Ekspertise er den spesialiseringen som gir høyest avkastning. Alle selskaper trenger ingeniører som kan distribuere og vedlikeholde modeller.
Tidsserieprognoser Det er et desperat behov for spesialister innen finans, forsyningskjede og energisektoren.
Eksperter på forsterkende læring er sjeldne og høyt verdsatt innen spill, robotikk og optimaliseringsproblemer.
Hvorfor spesialisering slår generalisering i ML-karrierer
Generalisten ML ingeniør blir foreldet. Bedrifter prøvde å ansette allsidige dyktige fagfolk. De lærte at bred kunnskap uten dybde ikke løser reelle problemer. En generalist forstår kanskje teorien bak transformatormodeller, men kan de faktisk finjustere en LLM for et spesifikt forretningsbruksscenario? Teori uten anvendelse flytter ikke målinger.
Spesialisering signaliserer ekspertise til ansettelsesledere. Når et selskap trenger noen til å bygge anbefalingsmotoren sin, ønsker de en ingeniør som har gjort det før. De ønsker ikke noen som lærer på jobben. Læringskurven er dyr. Produksjonsfeil koster penger. Spesialister risikerer ansettelsesbeslutninger.
Kompensasjonsforskjellen er betydelig. Generiske ML-ingeniører i mellomstore markeder tjener 150 000 til 200 000 dollar. Spesialister i områder med høy etterspørsel tjener 250 000 til 400 000 dollar eller mer. Forskjellen gjenspeiler verdien de skaper. En datasynspesialist som reduserer produksjonsfeil med 30 % genererer millioner i besparelser. Den effekten rettferdiggjør premiumkompensasjon.
Spesialisering skaper også karriereforsikring. Når oppsigelser skjer, overlever spesialistene. Bedrifter eliminerer overflødige stillinger først. Hvis du er en av ti generalister, kan du erstattes. Hvis du er den eneste personen som forstår anbefalingssystemet som driver 40 % av inntektene, er du essensiell.
Hos Ambacia ser vi dette mønsteret stadig vekk i våre plasseringsdata. Bedrifter kontakter oss med spesifikke krav. «Vi trenger en datasyningeniør med erfaring innen medisinsk bildebehandling.» «Vi ser etter en NLP-spesialist som har jobbet med flerspråklige modeller.» Generiske profiler samsvarer ikke med disse søkene. Spesialister gjør det.
Hva gjør NLP og LLM-ingeniørfag så etterspurt
Naturlig språkbehandling har gått fra akademisk forskning til forretningskritisk teknologi på bare to år. Alle selskaper ønsker nå å utnytte språkmodeller. Kundeserviceautomatisering, innholdsgenerering, dokumentbehandling, kodehjelp. Bruksområdet er uendelig. Etterspørselen etter ingeniører som faktisk kan bygge disse systemene overstiger tilbudet.
LLM-integrasjonsbølgen
Bedrifter har et kappløp om å integrere LLM-er i produktene sine. Men integrering er vanskeligere enn det ser ut til. Du kan ikke bare kalle et API og sende det til produksjon. Du må håndtere rask konstruksjon, konteksthåndtering, validering av utdata, kostnadsoptimalisering og krav til latens.
Ingeniører som forstår RAG (Retrieval Augmented Generation) er spesielt verdifulle. RAG begrunner LLM-utdata i faktiske data. Det reduserer hallusinasjoner. Det gjør modeller nyttige for bedriftsapplikasjoner der nøyaktighet er viktig. Å bygge effektive RAG-systemer krever forståelse av innebygde elementer, vektordatabaser, gjenfinningsstrategier og hvordan man evaluerer utdatakvalitet.
Ekspertise innen finjustering er like verdifull. Mange brukstilfeller trenger modeller tilpasset spesifikke domener. Medisinsk terminologi, juridisk språk, teknisk dokumentasjon. Standardmodeller fungerer ikke bra nok. Ingeniører som kan finjustere effektivt ved hjelp av teknikker som LoRA og QLoRA løser dette problemet.
NLP-applikasjoner fra den virkelige verden driver ansettelser
| Applikasjonsområde | Hva bedrifter trenger | Typisk kompensasjonsområde |
| Kundeservice automatisering | Intensjonsklassifisering, sentimentanalyse, responsgenerering | $ 180K - $ 280K |
| Dokumentintelligens | Informasjonsutvinning, oppsummering, klassifisering | $ 200K - $ 320K |
| Innholdsmoderering | Toksisitetsdeteksjon, identifisering av brudd på retningslinjer | $ 190K - $ 290K |
| Kodehjelp | Kodegenerering, feilsøking, dokumentasjon | $ 220K - $ 350K |
| Søk og oppdagelse | Semantisk søk, forståelse av spørringer, rangering | $ 210K - $ 340K |
Dokumentbehandling alene representerer enorme muligheter. Alle bedrifter har dokumenter. Kontrakter, fakturaer, rapporter, e-poster. Å utvinne strukturert informasjon fra ustrukturert tekst sparer utallige timer. Bedrifter betaler godt for ingeniører som kan bygge disse systemene pålitelig.
Flerspråklig NLP er spesielt verdifullt. De fleste selskaper ønsker å betjene globale markeder. Engelskspråklige løsninger gir penger på bordet. Ingeniører som forstår tverrspråklig overføringslæring og kan distribuere modeller som fungerer på tvers av språk er sjeldne. Denne sjeldenheten driver lønnen opp.
Ferdigheter som gjør deg ansettbar i NLP
Du trenger dyp forståelse av transformatorarkitekturer. Ikke bare overfladisk kunnskap. Du bør forstå oppmerksomhetsmekanismer, posisjonskodinger og hvorfor visse arkitekturvalg er viktige for ulike oppgaver.
Erfaring med store rammeverk er viktig. Hugging Face Transformers, LangChain, LlamaIndex. Bedrifter bruker disse verktøyene. Du må være produktiv med dem umiddelbart.
Prompt engineering er en reell ferdighet nå. Å vite hvordan man kan trekke ut ønsket atferd fra modeller er viktig. Få-skudds læring, tankekjede-promptering, strukturerte resultater. Disse teknikkene påvirker direkte kvaliteten på resultatene.
Erfaring med vektordatabaser dukker stadig oftere opp i jobbkravene. Pinecone, Weaviate, Qdrant, Chroma. RAG-systemer trenger effektivt likhetssøk. Å forstå hvordan man implementerer og optimaliserer disse systemene skiller deg ut.
Evalueringsmetoder er like viktige som å bygge modeller. Hvordan måler du om et LLM-resultat er bra? Menneskelig evaluering kan ikke skaleres. Du trenger automatiserte målinger, referansedatasett og valideringsrammeverk. Bedrifter sliter med dette. Ingeniører som løser det er verdifulle.

Hvorfor datavisjonsspesialister krever premiumlønninger
Datavisjonsapplikasjoner finnes overalt. Autonome kjøretøy, medisinsk bildebehandling, detaljhandelsanalyse, kvalitetskontroll i produksjon, sikkerhetssystemer, landbruksovervåking. Alle bransjer ønsker å hente ut innsikt fra visuelle data. Etterspørselen etter ingeniører som kan bygge disse systemene er intens.
Høyverdige datasynapplikasjoner
Autonome kjøretøy representerer det best betalte segmentet. Selskaper som Waymo, Cruise, Tesla og dusinvis av oppstartsbedrifter trenger datasyningeniører. De tekniske utfordringene er enorme. Sanntidsprosessering, sensorfusjon, håndtering av kantsaker, sikkerhetskritiske systemer. Ingeniører som jobber med autonome kjøretøy tjener mellom 300 000 og 500 000 dollar+ fordi problemene er vanskelige og innsatsen høy.
Medisinsk avbildning er et annet prioritert område. Radiologi, patologi, dermatologi. Kunstig intelligens hjelper leger med diagnose. Men medisinsk avbildning krever spesiell ekspertise. Du må forstå kliniske arbeidsflyter, regulatoriske krav og tolkbarhet. Modeller som ikke kan forklare beslutningene deres er ikke nyttige. Ingeniører som bygger bro mellom den tekniske og kliniske verdenen er mangelvare.
Detaljhandel og e-handel bruker datasyn i stor grad. Visuelt søk, virtuell prøving, lagerstyring, automatisering av kassen. Amazon Go-butikker kjører på datasyn. Alle forhandlere ønsker lignende funksjoner. Avkastningen er tydelig. Reduser svinn, forbedrer kundeopplevelsen, optimaliserer driften.
Kvalitetskontroll i produksjonen tilbyr mindre glamorøst, men svært verdifullt arbeid. Oppdage feil på produksjonslinjer. Overvåke utstyr for prediktivt vedlikehold. Sikre produktkonsistens. Disse applikasjonene påvirker lønnsomheten direkte. Et system som fanger opp feil før forsendelse sparer millioner.
Tekniske ferdigheter som selskaper faktisk trenger
| Ferdighetsområde | Spesifikke teknologier | Hvorfor det gjelder |
| Objektdeteksjon | YOLO, Raskere R-CNN, RetinaNet | Kjernefunksjonalitet for de fleste CV-applikasjoner |
| Semantisk segmentering | U-Net, DeepLab, Mask R-CNN | Presis forståelse av pikselnivå |
| Videoanalyse | Optisk flyt, handlingsgjenkjenning, sporing | Temporal forståelse utover enkeltbilder |
| 3D-visjon | Punktskyer, dybdeestimering, SLAM | Robotikk og AR-applikasjoner |
| Edge-distribusjon | TensorRT, CoreML, ONNX | Begrensninger i den virkelige distribusjonen |
Ekspertise innen edge-distribusjon er spesielt verdifull. Mange datasynsapplikasjoner kjører på enheter, ikke servere. Autonome kjøretøy, mobiltelefoner, IoT-kameraer. Du må optimalisere modeller for å kjøre på begrenset maskinvare. TensorRT for NVIDIA-plattformer, CoreML for Apple-enheter, TensorFlow Lite for Android. Å forstå disse distribusjonsmålene og hvordan man optimaliserer for dem, skiller gode ingeniører fra eksepsjonelle ingeniører.
Dataannotering og aktiv læring er viktigere innen datasyn enn andre maskinlæringsområder. Merking av bilder er dyrt og tidkrevende. Ingeniører som kan minimere annoteringskrav gjennom smart sampling, overføringslæring og delvis overvåkede teknikker gir enorm verdi. Bedrifter bruker millioner på datamerking. Kutt den kostnaden med 50 %, og du er en helt.
Bryter seg inn i datasyn
Start med en portefølje av prosjekter som demonstrerer reelle ferdigheter. Bygg et objektdeteksjonssystem. Implementer semantisk segmentering. Lag noe som kjører i sanntid. GitHub-repoer med fungerende kode er viktigere enn sertifiseringer.
Fokuser på én vertikal i utgangspunktet. Medisinsk avbildning, autonome kjøretøy, detaljhandel, produksjon. Hver av dem har unike krav og utfordringer. Dybde i ett område er mer verdifullt enn overfladisk kunnskap på tvers av dem alle.
Bidra til åpen kildekode-prosjekter innen datasyn. OpenCV, MMDetection, Detectron2. Reelle bidrag bygger troverdighet. De lærer deg også hvordan datasynkode med produksjonskvalitet bør se ut.
Ambacia plasserer jevnlig datasyningeniører i stillinger over hele Europa og USA. Mangelen er reell. Bedrifter konkurrerer aggressivt om kvalifiserte kandidater. Hvis du har genuin datasynekspertise, spesielt innen verdifulle vertikaler som medisinsk avbildning eller autonome systemer, er mulighetene mange.
Hvordan anbefalingssystemingeniører blir uerstattelige
Anbefalingssystemer driver direkte inntekter. Bedre anbefalinger betyr mer engasjement, flere kjøp og høyere livstidsverdi. Bedrifter måler avkastning på investeringen tydelig. En forbedring på 5 % i anbefalingskvaliteten kan bety titalls millioner i ekstra inntekter. Denne direkte forretningsmessige effekten gjør anbefalingssystemingeniører ekstremt verdifulle.
Hvorfor anbefalingssystemer er så forretningskritiske
Netflix tilskriver betydelig abonnentretensjon til anbefalingsmotoren sin. Amazon hevder at 35 % av inntektene kommer fra anbefalinger. Spotifys Discover Weekly holder brukerne engasjerte. YouTubes anbefalingsalgoritme bestemmer hva milliarder ser på. Alle plattformselskaper trenger gode anbefalinger for å konkurrere.
Utfordringen er vanskeligere enn den ser ut til. Du forutsier ikke bare rangeringer. Du balanserer flere mål. Relevans, mangfold, nyhet, tilfeldigheter. Du må unngå filterbobler samtidig som du gir brukerne det de ønsker. Du har å gjøre med kaldstartproblemer for nye brukere og nye elementer. Du håndterer datamangel, popularitetsskjevhet og tilbakemeldingsløkker.
Anbefalinger i sanntid legger til et nytt lag med kompleksitet. Brukerkontekst er viktig. Tid på dagen, enhet, gjeldende øktatferd, nylige kjøp. Systemet ditt må tilpasse seg umiddelbart. Batchbehandling holder ikke lenger. Strømmearkitekturer, funksjonslagre, servering med lav latens. Infrastrukturkravene er betydelige.
Tekniske tilnærminger selskaper faktisk bruker
Samarbeidsfiltrering er fortsatt grunnleggende. Matrisefaktorisering, nevral samarbeidsfiltrering, grafbaserte tilnærminger. Du må forstå når hver tilnærming fungerer best og hvordan du implementerer dem effektivt i stor skala.
Innholdsbasert filtrering utfyller samarbeidsmetoder. Forståelse av elementfunksjoner, brukerprofiler og hvordan man matcher dem. Dyp læring muliggjorde rikere innholdsrepresentasjoner. Bildeinnbygging for visuell likhet, tekstinnbygging for semantisk likhet.
Hybride systemer som kombinerer flere tilnærminger gir best resultat. Stabling, blanding, kaskadering. Du kan bruke samarbeidende filtrering for bred gjenfinning, deretter innholdsbasert rangering, og deretter et siste nevralt nettverk som lærer å balansere flere signaler.
| Systemkomponent | Brukte teknologier | Skalabetraktninger |
| Kandidatgenerering | Omtrentlige nærmeste naboer, matrisefaktorisering | Reduser milliarder av elementer til tusenvis av kandidater |
| Ranking | Gradientforsterkede trær, nevrale nettverk | Vurder og ranger kandidater etter relevans |
| Ny rangering | Mangfoldsalgoritmer, forretningsregler | Sørg for at de endelige anbefalingene oppfyller flere mål |
| Servering | Redis, funksjonsbutikker, modellservere | Under 100 ms latens ved millioner av QPS |
| Evaluering | A/B-testing, offline-målinger | Mål faktisk forretningspåvirkning |
To-trinnsarkitekturer er standard i stor skala. Rask kandidatgenerering henter potensielt relevante elementer fra millioner av alternativer. Deretter gir langsommere, mer sofistikerte rangeringsmodeller disse kandidatene poeng. Dette balanserer beregningskostnader med anbefalingskvalitet.
Utforskning kontra utnyttelse er en kontinuerlig utfordring. Ren utnyttelse viser brukerne hva de sannsynligvis vil engasjere seg i. Men dette skaper filterbobler og forhindrer oppdagelse. Du trenger strategier for å introdusere nyhet og mangfold samtidig som du opprettholder engasjementet. Flerarmede banditttilnærminger, epsilon-grådige strategier, Thompson-sampling. Disse teknikkene krever både teoretisk forståelse og praktisk implementeringserfaring.
Bryte seg inn i anbefalingssystemer
Bygg et anbefalingssystem fra bunnen av. Bruk offentlige datasett. MovieLens, Amazon-produktdata, Spotify-spillelister. Implementer flere tilnærminger. Vis at du forstår avveiningene. Distribuer det slik at folk faktisk kan bruke det. Demonstrative prosjekter er enormt viktige ved ansettelser.
Lær de viktigste rammeverkene. TensorFlow-anbefalinger, PyTorch Geometric for grafbaserte tilnærminger, LightFM, Surprise. Kjennskap til disse verktøyene viser at du kan være produktiv umiddelbart.
Forstå evalueringsmålinger i dybden. Presisjon, gjenkjenning, NDCG, MAP. Men også forretningsmålinger. Klikkfrekvens, konverteringsfrekvens, inntekt per bruker, øktlengde. Bedrifter bryr seg om forretningsresultater, ikke bare algoritmiske målinger.
Studer anbefalingssystemer på store plattformer. Netflix, YouTube, Amazon og Spotify publiserer mye om systemene sine. Les ingeniørbloggene deres. Forstå deres arkitekturvalg. Lær av deres feil og suksesser.
Hva MLOps-ingeniører faktisk gjør, og hvorfor alle trenger dem
MLOps er den spesialiseringen innen maskinlæring med høyest avkastning på investeringen akkurat nå. Alle selskaper som bygger ML-systemer trenger MLOps-ekspertise. Ferdighetene overføres på tvers av bransjer og brukstilfeller. Hvis du er usikker på hvilken ML-spesialisering du skal velge, er MLOps det tryggeste valget.
MLOps-problemet selskaper står overfor
De fleste ML-modeller kommer aldri i produksjon. Anslag antyder at 80–90 % av modellene forblir i bærbare datamaskiner. Modellene fungerer under utvikling. Men å distribuere dem pålitelig i stor skala er en helt annen utfordring. Dette gapet mellom utvikling og produksjon er dyrt. Bortkastet forskningsinnsats, tapte muligheter, frustrerte team.
Selv modeller som når produksjonsprosessen feiler ofte stille. Ytelsen forringes over tid. Datadrift fører til at nøyaktigheten synker. Ingen merker det før det er et problem. Overvåkingssystemer finnes ikke eller fungerer ikke som de skal. Omskolering skjer manuelt og sjelden. Denne driftsbyrden er enorm.
Versjonskontroll for maskinlæring er vanskeligere enn for programvare. Du trenger versjonskode, data, modeller, konfigurasjoner og avhengighetene mellom dem. Én endring ødelegger alt. Reproduserbarhet blir umulig. Feilsøking er et mareritt.
Hva MLOps egentlig innebærer
MLOps-ingeniører bygger infrastruktur som gjør ML pålitelig og skalerbar. De lager opplæringsprosesser som kjører automatisk. De implementerer overvåkingssystemer som oppdager problemer tidlig. De bygger distribusjonssystemer som gjør modellutgivelse trygg og rask. De optimaliserer infrastrukturkostnader. De gjør dataforskere produktive.
Rollen krever varierte ferdigheter. Grunnleggende programvareutvikling. Kunnskap om distribuerte systemer. Ekspertise innen skyplattformer. Forståelse av ML-konsepter og arbeidsflyter. DevOps-praksiser tilpasset ML. Det er et bredt ferdighetssett, og det er derfor kvalifiserte MLOps-ingeniører er mangelvare.
| MLOps-komponent | Hva det inkluderer | Forretningsverdi |
| Datarørledninger | Inntak, validering, versjonering, transformasjon | Pålitelige inndata for modelltrening |
| Opplæringsrørledninger | Automatisert omtrening, hyperparameterjustering, eksperimentsporing | Raskere iterasjon og bedre modeller |
| Modellregister | Versjonskontroll, metadata, avstamningssporing | Styring og reproduserbarhet |
| Utplassering | CI/CD for modeller, A/B-testing, canary-utgivelser | Trygge utrullinger og raske tilbakerullinger |
| Overvåking | Ytelsesmålinger, datadrift, modellforfall | Oppdag problemer før de påvirker brukerne |
| Funksjonsbutikker | Sentralisert funksjonsadministrasjon, konsistens online/offline | Gjenbrukbarhet og serveringsprøyaktighet |
Funksjonslagre har dukket opp som kritisk MLOps-infrastruktur. De løser problemet med skjevhet i treningsservering. Funksjoner beregnet på én måte i trening og forskjellig i produksjon forårsaker subtile feil. Funksjonslagre sikrer konsistens. De muliggjør også gjenbruk av funksjoner på tvers av team. Bygg en funksjon én gang, bruk den overalt.
Modellovervåking går utover enkel nøyaktighetssporing. Du overvåker dataavvik, konseptavvik og ytelsesforringelse. Du sporer forretningsmålinger, ikke bare maskinlæringsmålinger. Du setter opp varsler som faktisk betyr noe. Du bygger dashbord som interessenter forstår.
Kostnadsoptimalisering er et stort problem. Opplæring av store modeller er dyrt. Å levere prediksjoner i stor skala koster betydelige penger. MLOps-ingeniører optimaliserer disse kostnadene. Instanser i riktig størrelse, spotinstanser, effektiv batching, modellkomprimering. En god MLOps-ingeniør kan kutte infrastrukturkostnader med 50 % samtidig som ytelsen opprettholdes eller forbedres.

Effektiv læring av MLO-er
Start med skyplattformer. AWS SageMaker, Google Vertex AI eller Azure ML. Velg én og lær den grundig. Disse plattformene tilbyr MLOps-infrastruktur rett ut av boksen. Å forstå hvordan man bruker dem effektivt er umiddelbart verdifullt.
Lær containerisering og orkestrering. Docker er viktig. Kubernetes forventes i økende grad. ML-arbeidsbelastninger kjører i containere. Du må være komfortabel med denne teknologistakken.
Forstå CI/CD-prinsipper og tilpasse dem til ML. GitHub Actions, GitLab CI, Jenkins. Å sette opp automatisert testing og distribusjon for ML-systemer krever en annen tenkning enn tradisjonell programvare.
Studer ML-overvåking og observerbarhet. Prometheus, Grafana, tilpassede loggingløsninger. Du må instrumentere ML-systemer riktig. Vit hva du skal måle og hvordan du skal måle det.
Ambacia samarbeider med en rekke selskaper som bygger opp MLOps-kompetansen sin fra bunnen av. Etterspørselen er langt større enn tilbudet. Bedrifter sliter med å finne ingeniører med denne kompetansen. Hvis du utvikler sterk MLOps-ekspertise, vil du ha flere muligheter enn du kan forfølge.
Hvor spesialister på tidsserieprognoser finner muligheter
Tidsserieprognoser er mindre glamorøse enn datasyn eller NLP. Det genererer ikke overskrifter. Men bedrifter trenger det desperat. Finans, forsyningskjede, energi, detaljhandel, helsevesen. Enhver bedrift med tidsdata trenger prognoser. Bruksområdene er uendelige, og etterspørselen er sterk.
Bransjer desperate etter tidsserieekspertise
Finans- og handelsfirmaer er det segmentet som betaler best. De forutsier aksjekurser, handelsvolumer og markedsvolatilitet. Høyfrekvent handel er avhengig av nøyaktige kortsiktige prognoser. Risikostyring krever modellering av ekstreme hendelser. Algoritmiske handelsstrategier trenger prognoser i kjernen. Kompensasjonen i toppfirmaer overstiger lett 300 000 dollar for erfarne tidsseriespesialister.
Forsyningskjede og logistikk trenger prognoser for etterspørselsplanlegging, lageroptimalisering og ressursallokering. Detaljhandelsbedrifter prognostiserer salg for å styre lagerbeholdning. Produksjonsbedrifter prognostiserer etterspørsel for å planlegge produksjon. Transportselskaper prognostiserer pakkevolum for å fordele kapasitet. Dårlig prognoser betyr tapte inntekter eller bortkastede ressurser. God prognoser driver lønnsomhet.
Prognoser for energisektoren er unike og verdifulle. Etterspørselen etter strøm varierer etter time og sesong. Produksjon av fornybar energi er avhengig av været. Nettoperatører trenger nøyaktige prognoser for å balansere tilbud og etterspørsel. Energihandel krever forutsigelse av priser. Smarte bygninger optimaliserer HVAC basert på beleggsprognoser. Dette domenet har spesifikke tekniske utfordringer og regulatoriske krav.
Helseapplikasjoner spenner fra å forutsi pasientinnleggelser til å forutsi sykdomsutbrudd. Sykehus må bemanne passende. Legemiddelselskaper forutsier legemiddeletterspørsel. Offentlige helsemyndigheter sporer epidemitrender. Disse applikasjonene har ofte konsekvenser for liv eller død.
Tekniske tilnærminger som betyr noe
Klassiske tidsseriemetoder er fortsatt viktige. ARIMA, eksponentiell utjevning, sesongmessig dekomponering. Disse teknikkene er godt forstått og fungerer ofte overraskende bra. Mange moderne tilnærminger sammenlignes med dem. Du må vite når enkle metoder er tilstrekkelige før du distribuerer komplekse nevrale nettverk.
Maskinlæring ga nye muligheter. Gradientforsterkede trær (XGBoost, LightGBM) håndterer flere funksjoner naturlig. De fanger opp ikke-lineære forhold. De fungerer bra med uregelmessige tidsserier. Mange vinnende Kaggle-løsninger bruker disse tilnærmingene.
Dyp læring for tidsserier har modnet betydelig. LSTM-er, GRU-er og transformatorbaserte modeller håndterer lange sekvenser. De kan lære komplekse tidsmønstre. Temporal Fusion Transformers, N-BEATS, DeepAR. Disse arkitekturene som er spesielt utviklet for prognoser, overgår generiske tilnærminger.
| Prognoser Utfordring | Effektive tilnærminger | Bransjeeksempler |
| Høyfrekvent kortsiktig | LSTM, oppmerksomhetsmekanismer | Handel, administrasjon av energinett |
| Langsiktig sesongbasert | Profeten, SARIMA, hybridmodeller | Planlegging av detaljhandelens etterspørsel |
| Flere relaterte serier | Hierarkiske modeller, grafiske nevrale nettverk | Forsyningskjede på tvers av lokasjoner |
| Uregelmessig prøvetaking | Interpolasjon, nevrale ODE-er | Helsevesen, sensornettverk |
| Ekstreme hendelser | Kvantilregresjon, ekstremverditeori | Risikostyring, forsikring |
Probabilistisk prognostisering er stadig mer nødvendig. Punktprognoser er ikke nok. Interessenter trenger usikkerhetsestimater. Prediksjonsintervaller, kvantilprognoser, fullstendige prediktive fordelinger. Teknikker som konform prediksjon gir prinsipiell usikkerhetskvantifisering.
Multivariat prognostisering med relaterte serier er vanlig. Du prognostiserer ikke én tidsserie isolert. Du har salg på tvers av flere produkter, steder og tidsperioder. Eller du har sensoravlesninger fra forskjellige enheter. Tilnærminger som utnytter sammenhenger mellom serier, er bedre enn å behandle hver enkelt serie uavhengig.
Bygge tidsserieekspertise
Arbeid med datasett fra den virkelige verden. Kaggle-konkurranser gir god praksis. M5-prognosekonkurranse, COVID-19-prognoseutfordringer, energiprognosekonkurranser. Disse datasettene har reelle egenskaper. Manglende verdier, sesongvariasjoner, trendendringer, avvikere.
Lær de viktigste bibliotekene og rammeverkene. Statsmodeller for klassiske metoder. Profet for additive modeller med sesongvariasjon. GluonTS og PyTorch-prognoser for dyp læring. Gjør deg kjent med API-ene deres og når du skal bruke hver av dem.
Forstå evalueringsmålinger spesifikke for prognoser. MAE, RMSE, MAPE, symmetrisk MAPE. Men også forretningsrelevante målinger. Lagerkostnader, handelsresultat, gebyrer for energiubalanse. Koble tekniske målinger til forretningsresultater.
Studer domenespesifikke utfordringer innen prognoser. Finans har andre krav enn detaljhandel. Energiprognoser står overfor unike begrensninger. Helseprognoser har regulatoriske hensyn. Velg et domene og gå i dybden.
Hvorfor eksperter på forsterkende læring er så sjeldne og verdifulle
Forsterkningslæring er fortsatt den mest utfordrende ML-spesialiseringen. Det er vanskeligere å lære, vanskeligere å anvende og vanskeligere å få det til å fungere pålitelig. Denne vanskeligheten skaper knapphet. Bedrifter trenger forsterkningslæringsekspertise, men finner den ikke lett. Denne ubalansen i tilbud og etterspørsel driver eksepsjonell kompensasjon for kvalifiserte ingeniører.
Hvor RL faktisk blir brukt
Spill er den mest synlige applikasjonen. AlphaGo, OpenAI Five, DeepMinds StarCraft-agenter. Spillselskaper bruker RL for NPC-atferd, justering av vanskelighetsgrad og spilltesting. Men dette representerer en liten brøkdel av RL-mulighetene.
Robotikk er i stor grad avhengig av RL. Trener roboter til å manipulere objekter, navigere i miljøer eller samarbeide med mennesker. Simuleringsbasert trening overføres deretter til den virkelige verden. Bedrifter som bygger industriroboter, lagerautomatisering eller serviceroboter trenger RL-ekspertise.
Anbefalingssystemer bruker i økende grad RL-formuleringer. Brukerengasjement er en langsiktig belønning, ikke umiddelbar tilbakemelding. RL-tilnærminger kan optimalisere for livstidsverdi snarere enn neste klikk. Dette bruksområdet vokser raskt.
Ressursoptimaliseringsproblemer passer naturlig for RL. Optimalisering av kjøling i datasentre. Tildeling av skyressurser. Kontroll av trafikklys. Nettverksruting. Disse sekvensielle beslutningsproblemene under usikkerhet kartlegges godt til RL-rammeverk.
Autonome systemer utover bare kjøretøy bruker RL. Droner, undervannsfartøy, romfartøy. Ethvert system som trenger å lære av samhandling med komplekse miljøer kan potensielt dra nytte av RL-tilnærminger.
Hvorfor RL er så utfordrende
Tilbakemeldingssløyfen er forskjellig fra veiledet læring. Du har ikke merkede eksempler. Du har belønninger som kan komme etter mange handlinger. Du må balansere utforskning og utnyttelse. Du står overfor problemer med poengtildeling. Hvilke handlinger førte til hvilke resultater?
Effektivitet i samplinger er en stor utfordring. RL-algoritmer trenger ofte millioner av miljøinteraksjoner for å lære. Dette fungerer i simulering, men er uoverkommelig i virkelige systemer. Nylige fremskritt innen effektiv RL i samplinger hjelper, men har ikke løst problemet.
Belønningsdesign er notorisk vanskelig. Spesifiser feil belønning, og agenten din lærer feil atferd. Klassisk eksempel: en robot lærer å falle for å unngå å gå fordi fall ikke gir noen negativ belønning. Belønningsutforming og invers forsterkningslæring hjelper, men krever ekspertise.
Stabilitet og reproduserbarhet er vanskeligere enn i veiledet læring. Små hyperparameterendringer forårsaker store ytelsesforskjeller. Tilfeldige frø betyr mer. Resultatene er vanskeligere å reprodusere. Dette frustrerer forskere og gjør produksjonsdistribusjon utfordrende.
Bygge RL-ferdigheter
Start med simulerte miljøer. OpenAI Gym tilbyr standard benchmarks. MuJoCo for fysikksimulering. Unity ML Agents for spilllignende miljøer. Du trenger et sted å trene policyer uten konsekvenser for den virkelige verden.
Implementer algoritmer fra bunnen av minst én gang. Policygradienter, DQN, A3C, PPO, SAC. Forståelse av matematikk og implementeringsdetaljer er viktigere i RL enn i andre ML-områder. Du vil feilsøke problemer som krever denne dype forståelsen.
Studer vellykkede applikasjoner. Les artikler om DeepMind og OpenAI. AlphaGo, AlphaStar, Dactyl, OpenAI Five. Forstå deres arkitekturvalg, belønningsstrukturer og treningsprosedyrer. Lær av velprøvde tilnærminger.
Fokuser på ett applikasjonsdomene. Robotikk, spill-AI eller optimaliseringsproblemer. Hvert domene har unike hensyn. Dybde i ett område er mer verdifullt enn overfladisk kunnskap på tvers av all RL.
Ambacia plasserer av og til spesialister innen RL, men erkjenner nisjekarakteren til disse rollene. Hvis du utvikler ekte RL-ekspertise, finnes det muligheter, men de er mer konsentrerte i spesifikke selskaper. Forskningslaboratorier, robotikkselskaper, store teknologiselskaper med avanserte AI-team. Stillingene er færre, men konkurransen er også begrenset.
Hvordan velge din ML-spesialisering strategisk
Å velge en spesialisering er en strategisk karrierebeslutning. Velg riktig, og dører åpner seg. Velg feil, og du sliter med å finne muligheter. Flere faktorer bør styre beslutningen din.
Tilpass deg dine interesser og styrker
Du vil bruke år på å utvikle dyp ekspertise. Velg noe du faktisk liker. Hvis det å jobbe med tekst og språk gir deg entusiasme, bør du forfølge NLP. Hvis visuelle problemer fascinerer deg, bør du gå inn i datasyn. Vedvarende interesse er viktig for langsiktig suksess.
Vurder dine eksisterende ferdigheter og bakgrunn. Programvareingeniører går ofte godt over i MLOps. Det utnytter deres infrastrukturekspertise. Statistikere kan trekkes mot tidsserieprognoser. En bakgrunn med mye matematikk passer til forsterkningslæring. Bygg på dine styrker.
Din domenekunnskap påvirker valg av spesialisering. Helsebakgrunn gjør medisinsk avbildning naturlig. Finanserfaring hjelper med tidsserieprognoser i markeder. Erfaring med e-handel gir kontekst for anbefalingssystemer. Domeneekspertise kombinert med ML-ferdigheter er kraftig.
Evaluer markedsetterspørselen realistisk
Noen spesialiseringer har flere ledige stillinger enn andre. NLP og MLOps har de bredeste mulighetene for tiden. Datasyn og anbefalingssystemer har sterk etterspørsel i spesifikke bransjer. Tidsserieprognoser har jevn etterspørsel, men mindre hype. RL har begrensede, men godt betalte muligheter.
Geografisk plassering er viktig. Datavisjonsjobber konsentrerer seg rundt knutepunkter for autonome kjøretøy. Tidsserieroller innen fintech grupperes i finanssentre. Fjernarbeid har utvidede alternativer, men noen spesialiseringer har flere fjernarbeidsmuligheter enn andre.
Vurder bransjetrender. LLM-integrasjon er populært nå, men kan mettes om 2 til 3 år. Etterspørselen etter MLOps vil sannsynligvis holde seg sterk ettersom flere selskaper produserer ML. Datavisjonsapplikasjoner fortsetter å ekspandere til nye bransjer. Prøv å se forbi dagens hype til bærekraftig etterspørsel.
Faktor i læringskurve og hindringer for inngang
Noen spesialiseringer er lettere å komme inn i enn andre. NLP med moderne LLM-er har en mildere læringskurve. Du kan raskt bygge nyttige applikasjoner. MLOps krever brede ferdigheter, men hver del er lærbar. Tidsserieprognoser har veletablerte metoder og tydelig evaluering.
Datasyn krever betydelige studier, men har rikelig med læringsressurser. Forsterkningslæring har den bratteste læringskurven og er vanskeligst å praktisere uten simuleringsmiljøer.
Vurder tidsinvesteringen som kreves. Kan du utvikle kompetanse på juniornivå på 6 måneder? Middels ferdigheter på 18 måneder? Ekspertnivå på 3 til 5 år? Din nåværende situasjon påvirker hva som er realistisk.
Langsiktig karrierebane
Tenk på hvor hver spesialisering fører. MLO-er kan føre til roller innen ML-infrastruktur eller ML-plattformteam. Datavisjon kan føre til robotikk eller autonome systemer. NLP-spesialister kan gå over til roller innen AI-produkt. Tidsserieprognoser kan føre til kvantitative roller innen finans.
Noen spesialiseringer har tydeligere utviklingsveier enn andre. Vurder om du vil forbli dypt teknisk eller etter hvert bevege deg mot lederskap. Noen spesialiseringer forbereder deg bedre for roller som sjefsingeniør eller arkitekt. Andre posisjonerer deg for teknisk lederskap.
Lønnsutviklingen varierer på tvers av spesialiseringer. RL-spesialister i toppselskaper kan overstige $500 000, men mulighetene er begrensede. MLOps-ingeniører har flere muligheter, men noe lavere topplønn. NLP-roller spenner over det bredeste spekteret avhengig av applikasjon og selskap.
Hos Ambacia veileder vi kandidater gjennom disse vurderingene regelmessig. Riktig spesialisering avhenger av din unike situasjon. Dine ferdigheter, interesser, beliggenhet, karrieremål og markedstiming spiller alle en rolle. Det som fungerer for én ingeniør, fungerer kanskje ikke for en annen. Nøkkelen er å ta et informert, strategisk valg i stedet for å følge hypen.
Ta grep med ML-spesialiseringen din i dag
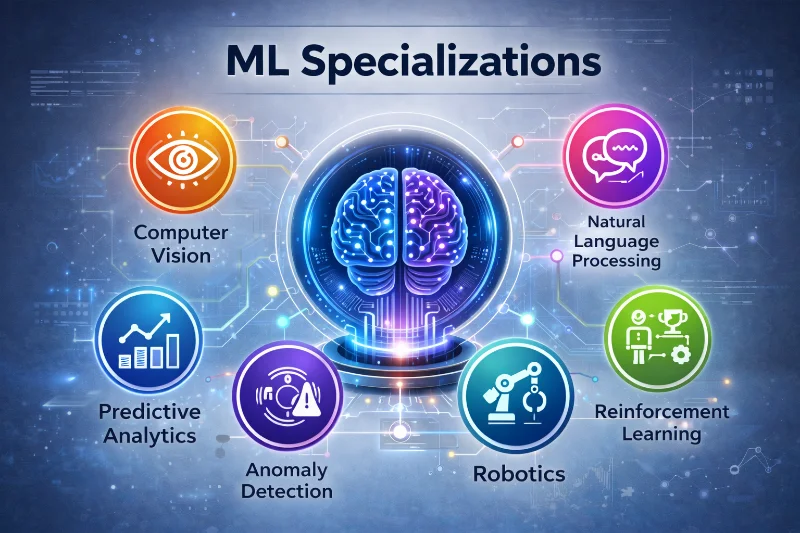
Nå forstår du hvilke ML-spesialiseringer bedrifter desperat trenger. NLP- og LLM-ingeniørfag, datasyn, anbefalingssystemer, MLOps, tidsserieprognoser og forsterkningslæring. Hver av dem tilbyr sterke karrieremuligheter for ingeniører som utvikler genuin ekspertise.
Neste steg er å velge din vei og forplikte deg til den. Slutt å spre deg tynt utover alle ML-underdomener. Velg én spesialisering som samsvarer med dine interesser og markedets etterspørsel. Gå dypt i stedet for bredt.
Bygg en portefølje som viser reell ekspertise. Bedrifter ansetter basert på hva du har gjort, ikke hvilke kurs du har fullført. Send prosjekter. Bidra til åpen kildekode. Skriv om hva du lærer. Gjør ekspertisen din synlig.
Nettverk innenfor din valgte spesialisering. Bli med i fellesskap, delta på konferanser, følg tankeledere. ML-feltet er lite nok til at omdømme betyr noe. Folk ansetter ingeniører de kjenner eller som anbefales av pålitelige kilder.
Klar til å utforske muligheter innen din valgte ML-spesialisering? Ambacia kobler spesialiserte ML-talenter med selskaper over hele Europa og globalt. Vi samarbeider med organisasjoner som aktivt ansetter for NLP, datasyn, MLOps og andre ML-spesialiseringer. Enten du utforsker din første spesialiserte rolle eller er klar for å ta et steg videre på seniornivå, kan vi hjelpe deg med å finne muligheter som samsvarer med din ekspertise og karrieremål. La oss diskutere hvordan din spesialisering passer inn i dagens marked og hvor du kan gjøre størst innvirkning.

FAQ
1. Hvilken ML-spesialisering har størst etterspørsel akkurat nå?
NLP og LLM-ingeniørfag leder for tiden ansettelsesetterspørselen. Alle selskaper ønsker å integrere språkmodeller i produktene sine. Kundeserviceautomatisering, dokumentbehandling, innholdsgenerering og kodehjelpsapplikasjoner driver denne etterspørselen.
MLOps følger tett bak. Alle organisasjoner som distribuerer ML-systemer trenger ingeniører som kan bygge pålitelig produksjonsinfrastruktur. Gapet mellom forskning og produksjon skaper enorme muligheter for MLOps-spesialister.
Datasyn har sterk etterspørsel i flere bransjer. Autonome kjøretøy, medisinsk avbildning, detaljhandelsanalyse og kvalitetskontroll i produksjon krever alle datasynsekspertise. Bruksområdene er varierte og godt finansierte.
Markedetterspørselen endrer seg over tid. LLM-integrasjon kan mettes om 2 til 3 år etter hvert som flere ingeniører utvikler disse ferdighetene. Etterspørselen etter MLOps vil sannsynligvis forbli sterk lenger fordi den gjelder alle ML-systemer uavhengig av den spesifikke teknikken.
Hvis du bestemmer deg for hvilken spesialisering du skal forfølge, bør du vurdere både nåværende etterspørsel og langsiktig bærekraft. Å jobbe med spesialiserte IT-rekrutteringsbyråer som Ambacia kan gi innsikt i ansettelsestrender og hvilke spesialiseringer som ser den mest aktive rekrutteringen i ditt geografiske målmarked.
2. Hvor lang tid tar det å bli jobbklar innen en ML-spesialisering?
Tidslinjen varierer betydelig basert på utgangspunktet ditt og den valgte spesialiseringen. Hvis du har sterke grunnleggende kunnskaper om programvareutvikling og grunnleggende kunnskap om maskinlæring, kan du oppnå juniorkompetanse på 6 til 9 måneder med fokusert studie og praksis.
MLO-er og anbefalingssystemer er kanskje raskest å komme inn i hvis du har bakgrunn innen programvareutvikling. Du bygger på eksisterende ferdigheter. NLP med moderne LLM-er har også en relativt svak læringskurve fordi du raskt kan bygge nyttige applikasjoner ved hjelp av forhåndstrente modeller.
Datasyn krever vanligvis 12 til 18 måneder for å utvikle jobbklare ferdigheter. Feltet har dybde, og du må forstå ulike arkitekturer og deres avveininger. Tidsserieprognoser er lignende, og krever dyp forståelse av statistiske metoder og moderne dyp læringsmetoder.
Forsterkningslæring har den bratteste læringskurven. Forvent minimum 18 til 24 måneder for å utvikle ekte kompetanse. De matematiske grunnlagene er krevende, og praktisk erfaring krever simuleringsmiljøer.
Ekspertise på mellomnivå til seniornivå tar lengre tid. Planlegg 2 til 3 år med fokusert arbeid for å utvikle den dype ekspertisen som gir høyere lønn. Dette inkluderer frakt av produksjonssystemer, håndtering av edge cases og utvikling av intuisjon for hva som fungerer i praksis kontra teori.
3. Kan jeg bytte mellom ML-spesialiseringer senere i karrieren min?
Ja, det er mulig å bytte spesialisering, men det blir vanskeligere etter hvert som du utvikler deg. Tidlig i karrieren har du mer fleksibilitet. Med 2 til 3 års erfaring er det enkelt å gå over til en annen spesialisering. Du har grunnleggende ML-kunnskaper og ett dybdeområde. Det er håndterbart å lære et annet.
Overganger midt i karrieren krever mer begrunnelse. Med 5+ år innen datasyn betyr bytte til NLP å konkurrere med folk som har årelang NLP-spesifikk erfaring. Du vil sannsynligvis ta et skritt tilbake i ansiennitet og kompensasjon i starten. Men din ML-modenhet overføres. Du vil utvikle deg raskere enn noen som er helt ny innen ML.
Relaterte spesialiseringer er enklere å bygge bro over. MLOps-ingeniører kan gå over til ML-plattformteknikk. Datavisjonsspesialister kan bevege seg inn i robotikk. NLP-ingeniører kan flytte fokus fra tradisjonelle metoder til LLM-applikasjoner. Disse overgangene utnytter eksisterende kunnskap.
Noe ferdighetsoverføring på tvers av alle spesialiseringer. Produksjonsdistribusjon, overvåking, evalueringsmetoder, skyinfrastruktur. Å bygge disse grunnleggende funksjonene tidlig gir fleksibilitet senere.
Den beste strategien er å velge en spesialisering du kan forplikte deg til i minst 3 til 5 år. Utvikle genuin ekspertise før du vurderer et bytte. Overfladisk kunnskap på tvers av flere områder er mindre verdifull enn dybde på ett.
4. Trenger jeg en spesifikk grad for å spesialisere meg innen ML-områder som datasyn eller NLP?
Det kreves ingen spesifikk grad for de fleste ML-spesialiseringene. Bakgrunn innen informatikk, matematikk, statistikk, fysikk og ingeniørfag fungerer alle. Det som betyr noe er din evne til å lære de nødvendige konseptene og bygge produksjonssystemer.
Datasyn og NLP drar nytte av et sterkt matematisk grunnlag. Lineær algebra, kalkulus, sannsynlighet og statistikk er viktig. Hvis graden din dekket disse emnene, har du et solid utgangspunkt. Hvis ikke, må du fylle disse hullene gjennom selvstudium.
MLOps bryr seg mer om programvareutviklingsferdigheter enn avansert matematikk. Distribuerte systemer, skyplattformer og DevOps-praksis er viktigere. Programvareingeniører uten ML-bakgrunn kan lettere gå over til MLOps enn til forskningstunge spesialiseringer.
Statistikk er en fordel for tidsserieprognoser. Økonometri, signalbehandling eller kvantitative felt gir relevant forberedelse. Men du kan lære den nødvendige statistikken gjennom dedikerte studier.
Forsterkningslæring er den mest matematisk krevende spesialiseringen. Kontrollteori, optimalisering og sannsynlighetsteori er grunnleggende. En grad som berører disse områdene er nyttig, men er ikke obligatorisk hvis du er villig til å studere selvstendig.
Praktisk erfaring veier tyngre enn kvalifikasjoner etter inngangsnivå. Når du har to eller flere år med produksjonssystemer innen skipsfart, er det ingen som spør om graden din. De bryr seg om hva du har bygget og hvilken innvirkning du har skapt.
5. Hvilken ML-spesialisering gir den beste balansen mellom jobb og fritid?
Balansen mellom arbeid og fritid varierer mer fra bedrift til bedrift og team til spesialiseringsgruppe. Når det er sagt, finnes det noen mønstre på tvers av spesialiseringer.
MLOps-roller har ofte ansvar for beredskap. Produksjonssystemer går i stykker på ubeleilige tidspunkter. Hvis du vedlikeholder kritisk ML-infrastruktur, kan det hende du håndterer hendelser utenom vanlige arbeidstider. Modne MLOps-organisasjoner roterer imidlertid på beredskapsoppgaver og bygger pålitelige systemer som sjelden går i stykker.
Anbefalingssystemer og tidsserieprognoser gir vanligvis bedre balanse mellom arbeid og fritid. Arbeidet er viktig, men sjelden haster. Du optimaliserer systemer som allerede fungerer. Frister finnes, men er vanligvis forutsigbare.
Datasyn for autonome kjøretøy kan være krevende. Sikkerhetskritiske systemer og konkurransepress skaper intense miljøer. Medisinsk avbildning har en tendens til å ha rimeligere arbeidstid med mindre du er i en raskt voksende oppstartsbedrift.
NLP- og LLM-teknikk varierer mye. Oppstartsbedrifter som kjemper om å levere LLM-applikasjoner har ofte intense kriser. Etablerte selskaper som integrerer LLM-er i eksisterende produkter har vanligvis et mer bærekraftig tempo.
Forskningsroller innen forsterkende læring kan ha størst fleksibilitet. Du løser vanskelige problemer med lange tidsfrister. Daglige timer betyr mindre enn å gjøre fremskritt. Stillingene er imidlertid begrenset.
Bedriftskultur påvirker balanse mer enn spesialisering. Et modent selskap med god ingeniørpraksis tilbyr bedre balanse uavhengig av spesialisering. Tidligfase-oppstartsbedrifter innen enhver spesialisering har en tendens til å være krevende.
6. Hvor mye tjener ML-spesialister sammenlignet med vanlige ML-ingeniører?
ML-spesialister tjener betydelig mer enn generalister. Forskjellen øker med erfaring. På inngangsnivå kan forskjellen være 10 % til 20 %. På seniornivå kan spesialister tjene 50 % til 100 % mer enn generalister.
Generelle ML-ingeniører i mellomstore selskaper tjener en total kompensasjon på 150 000 til 200 000 dollar. Spesialister i områder med høy etterspørsel tjener 250 000 til 400 000 dollar eller mer. Forskjellen gjenspeiler verdien de skaper og hvor knappe de er i markedet.
Spesifikke spesialiseringer krever ulike premier. Spesialister på forsterkningslæring i toppselskaper kan tjene over 500 000 dollar, men mulighetene er begrensede. Datasyningeniører som jobber med autonome kjøretøy tjener 300 000 til 500 000 dollar. NLP-spesialister med LLM-ekspertise ser for tiden sterk etterspørsel og kompensasjon i området 250 000 til 400 000 dollar.
MLOps-spesialister tjener 220 000 til 350 000 dollar, avhengig av selskap og sted. Spesialister på tidsserieprognoser innen finans tjener 280 000 til 450 000 dollar. Anbefalingssystemingeniører på store plattformer tjener 260 000 til 400 000 dollar.
Disse lønnsintervallene inkluderer grunnlønn, aksjer og bonuser. Geografisk plassering påvirker tallene betydelig. San Francisco og New York betaler mer. Europeiske markeder betaler mindre enn amerikanske markeder, men gapet for eksterne stillinger blir mindre.
Hos Ambacia ser vi konsistente data som viser at spesialister får 30 % til 50 % høyere tilbud enn generalister med tilsvarende års erfaring. Markedet belønner dybde fremfor bredde på alle erfaringsnivåer.
7. Bør jeg lære flere ML-spesialiseringer eller fokusere på bare én?
Fokuser først på én spesialisering. Utvikle genuin ekspertise før du utvider. Dybde skaper karrieremuligheter og gir høy lønn. Bredde er nyttig, men sekundært.
Planlegg for 2 til 3 år med fokus på din primære spesialisering. Bygg produksjonssystemer. Håndter edge cases. Utvikle intuisjon. Bli noen som kan løse vanskelige problemer innen det feltet. Denne dybden gjør deg ansettbar og verdifull.
Etter å ha etablert dybde, gir strategisk bredde mening. Å legge til komplementære ferdigheter øker effekten din. En NLP-spesialist som forstår MLO-er kan distribuere sine egne modeller. En datasyningeniør som lærer anbefalingssystemer kan bygge visuelle søk. Men legg til bredde for å forbedre spesialiseringen din, ikke for å utvanne den.
Noen grunnleggende ferdigheter gjelder på tvers av spesialiseringer. Produksjonsdistribusjon, overvåking, skyplattformer, evalueringsmetoder. Invester i disse uavhengig av spesialisering. De mangedobler effektiviteten din.
Unngå fellen med å samle overfladisk kunnskap på tvers av mange områder. Bedrifter ansetter ikke ingeniører som har tatt alle kurs, men ikke levert noe. De ansetter spesialister som har løst reelle problemer i produksjonen.
Markedet belønner T-formede ferdigheter. Dyp ekspertise på ett område (den vertikale stangen) med bred forståelse av relaterte områder (den horisontale stangen). Fokuser på å utvikle den vertikale dybden først.
8. Hvilke ressurser er best for å lære ML-spesialiseringer?
Læringsressursene varierer etter spesialisering, men noen mønstre gjelder. Start med grunnleggende kurs for å forstå teori. Gå deretter raskt videre til praktiske prosjekter. Å lese forskningsartikler hjelper, men bør ikke dominere tiden din.
For NLP og LLM-er er dokumentasjon og veiledninger for Hugging Face utmerket. Bygg applikasjoner ved hjelp av forhåndstrente modeller. Finjuster modeller for spesifikke oppgaver. Det offisielle Transformers-kurset dekker moderne NLP i sin helhet. Følg forskning fra Anthropic, OpenAI og Google på LLM-utvikling.
Datasynstudenter bør studere FastAI-kurset og Stanfords CS231n. Implementer arkitekturer fra bunnen av minst én gang. Arbeid med ekte bildedatasett. Kaggle-konkurranser gir god øvelse med realistiske problemer.
MLOps krever bred læring. Start med én skyplattform i dybden. AWS Machine Learning Specialty eller Google Professional ML Engineer-utdanningen fungerer bra. Les «Machine Learning Engineering» av Andriy Burkov. Følg ingeniørblogger fra Netflix, Uber og Airbnb som beskriver ML-infrastrukturen deres.
Tidsserieprognoser drar nytte av både klassiske og moderne tilnærminger. Rob Hyndmans «Forecasting: Principles and Practice» dekker statistiske metoder. Lær deretter moderne dyp læringsmetoder gjennom PyTorch Forecasting-dokumentasjon og GluonTS-veiledninger.
Forsterkningslæring krever et sterkt teoretisk grunnlag. Sutton og Bartos «Forsterkningslæring: En introduksjon» er viktig. OpenAI Spinning Up tilbyr praktiske implementeringer. Arbeid deg gjennom simulerte miljøer før du prøver virkelige applikasjoner.
Bøker, kurs og veiledninger bygger kunnskap. Men prosjekter bygger ferdigheter. Bruk 70 % av tiden din på å bygge og 30 % på å studere. Dette forholdet akselererer praktisk kompetanse.
9. Hvordan vet jeg hvilken ML-spesialisering som passer min bakgrunn og mine ferdigheter?
Dine eksisterende ferdigheter og bakgrunn tyder på naturlige tilpasninger. Programvareingeniører passer godt inn i MLOps. Din erfaring med infrastruktur og distribusjon er direkte relevant. Læringskurven fokuserer på ML-spesifikke utfordringer snarere enn programvaregrunnleggende.
Dataforskere jobber ofte med tidsserieprognoser eller anbefalingssystemer. Din statistiske bakgrunn og forståelse av forretningskontekst gir fordeler. Du legger til produksjonstekniske ferdigheter i tillegg til de analytiske evnene du allerede har.
Bakgrunn i matematikk og fysikk passer for datasyn og forsterkningslæring. Disse spesialiseringene er matematisk intensive. Din kvantitative opplæring akselererer læringen av komplekse algoritmer og deres teoretiske grunnlag.
Domenekompetanse påvirker valg av spesialisering. Helsefaglig bakgrunn gjør medisinsk avbildning naturlig. Finanserfaring hjelper med tidsserieprognoser i markeder. E-handelserfaring gir kontekst for anbefalingssystemer. Å kombinere domenekunnskap med ML-ferdigheter skaper kraftig differensiering.
Tenk over hvilke typer problemer som begeistrer deg. Hvis språk og kommunikasjon fascinerer deg, bør du forfølge NLP. Hvis visuell informasjonsbehandling interesserer deg, bør du velge datasyn. Hvis det å bygge pålitelige systemer tilfredsstiller deg, bør du fokusere på MLOps. Vedvarende interesse over år krever genuin nysgjerrighet rundt problemområdet.
Ambacia hjelper kandidater regelmessig med å vurdere spesialiseringsegnethet. Vi ser på din bakgrunn, ferdigheter, interesser og målbedrifter. Riktig spesialisering samsvarer med dine styrker med markedsetterspørsel og personlige interesser. Denne tilpasningen akselererer læring og karriereutvikling.
10. Er ML-spesialiseringer stabile karrierevalg, eller vil de bli foreldet?
ML-spesialiseringer er stabile karrierevalg i overskuelig fremtid. Feltet modnes, ikke krymper. Etterspørselen etter spesialisert ML-ekspertise fortsetter å vokse etter hvert som flere selskaper tar i bruk AI-systemer i produksjon.
Det finnes en viss bekymring for om AI-verktøy automatiserer selve ML-utviklingen. GitHub Copilot og lignende verktøy hjelper ingeniører med å skrive kode raskere. De erstatter ikke den nødvendige vurderingsevnen for produksjonssystemer. Noen må fortsatt designe arkitekturer, velge passende teknikker, distribuere pålitelig og vedlikeholde systemer.
Spesifikke teknikker innen spesialiseringer utvikler seg. Datasyn gikk fra håndlagde funksjoner til dyp læring. NLP gikk fra statistiske modeller til transformatorer til LLM-er. Men kjerneproblemene gjenstår. Bedrifter trenger fortsatt visuell forståelse, språkbehandling og nøyaktige prediksjoner.
MLOps blir viktigere etter hvert som bruken av ML øker. Alle selskaper som distribuerer modeller trenger produksjonsinfrastruktur. Denne spesialiseringen har lang levetid fordi den gjelder uavhengig av hvilke ML-teknikker som er populære.
Ingeniørene som er mest fremtidssikret er de som fokuserer på å løse forretningsproblemer i stedet for å mestre spesifikke verktøy. Verktøy endres stadig. Evnen til å identifisere verdifulle problemer, velge passende løsninger og levere produksjonssystemer er fortsatt verdifull.
Noen spesialiseringer har lengre rullebaner enn andre. MLOps, datasyn og tidsserieprognoser dekker grunnleggende behov som ikke kommer til å forsvinne. Spesielt LLM-ingeniørfag kan endre seg etter hvert som teknologien modnes, men NLP vil generelt sett forbli relevant.
Karriereforsikring kommer fra dybde pluss tilpasningsevne. Utvikle dyp ekspertise på ett område. Bygg sterke grunnleggende prinsipper som kan overføres på tvers av teknikker. Hold deg oppdatert på ny utvikling. Denne kombinasjonen skaper robuste karrierer uavhengig av hvordan spesifikke teknologier utvikler seg.
Arbeidsmarkedet for maskinlæring endrer seg raskt. Å samarbeide med byråer som Ambacia, som sporer markedstrender, hjelper deg med å holde deg oppdatert på hvilke spesialiseringer som vokser kontra som metter.